Comammox Nitrospira能够在单个细胞内完成从氨到硝酸盐的转化,且相比经典氨氧化微生物排放更少的N2O,因此其准确检测对评估土壤氮循环和温室气体收支具有重要意义。目前,amoA基因高通量测序已成为comammox Nitrospira群落研究的主要手段,但可靠分类注释仍是瓶颈:现有引物特异性有限,常用数据库在较细分类水平上分辨率不足,常导致大量序列未分类或分配不一致;传统系统发育分析虽然可靠,却难以直接应用于高通量测序产生的海量序列。
针对这一问题,我院土壤生态学团队收集了从2015-2025年发表的140篇comammox Nitrospira系统发育研究中报道的amoA序列,并补充108条来自宏基因组组装基因组、长度超过700 bp的相关序列。经过去冗余、比对和系统发育树构建,仅保留在系统发育位置与既有A.1、A.2、A.3或B谱系框架一致的序列,最终建成包含506条参考序列的系统发育验证数据库。在此基础上,团队将该数据库整合进标准化QIIME 2工作流程:原始序列经质控、去引物、拼接、去噪和嵌合体去除后获得ASV,再通过VSEARCH和BLAST consensus分类器进行注释。
为评估性能,研究开展了内部验证和外部验证。内部验证包括分层十折交叉验证和基于95%序列一致性聚类的六折交叉验证;外部验证覆盖旱地土壤、稻田土壤、水产养殖塘、互花米草沼泽和泥滩等独立环境数据集。结果表明,该工作流与系统发育验证的支系分配高度一致,主要支系A和B之间未出现交叉误分类。在分层十折交叉验证中,代表性较充分的A.1、A.2和B支系,精确率、召回率和F1分数达98%—100%;A.3因参考序列较少,分类表现相对较低。外部验证中,自动化注释与最大似然系统发育分配的一致性至少为98%,在稻田土壤、水产养殖塘和互花米草沼泽中达到100%。此外,332个系统发育验证的非目标ASV均未被错误注释为comammox Nitrospira,假阳性率为0%。与NCBI nr/nt数据库相比,该数据库对A.1、A.2、A.3等系统发育定义谱系提供了更一致、更细化的分辨,并提高了B支系获得明确谱系注释的比例。
该研究建立了系统发育验证的comammox NitrospiraamoA基因的参考数据库和标准化QIIME 2工作流程,将系统发育分析的分类可靠性与高通量自动化注释的快速、可扩展优势相结合,可实现comammox Nitrospira序列的快速、准确和可重复分类,并减少非目标序列和模糊分配对下游分析的影响,为大规模comammox Nitrospira群落生态研究提供了标准化分类框架。相关数据库和脚本已在GitHub (https://github.com/clairehyh99/Comammox-Nitrospira-annotation)开源,可供同行直接使用和进一步拓展。
相关成果以“An optimized workflow for accurate taxonomic annotation of high-throughput comammox Nitrospira sequences”为题,发表于 European Journal of Soil Biology。论文第一作者为我院2023级博士生冯蒙蒙,通讯作者为林永新研究员和贺子洋博士(现为中国科学院城市环境研究所博士后)。
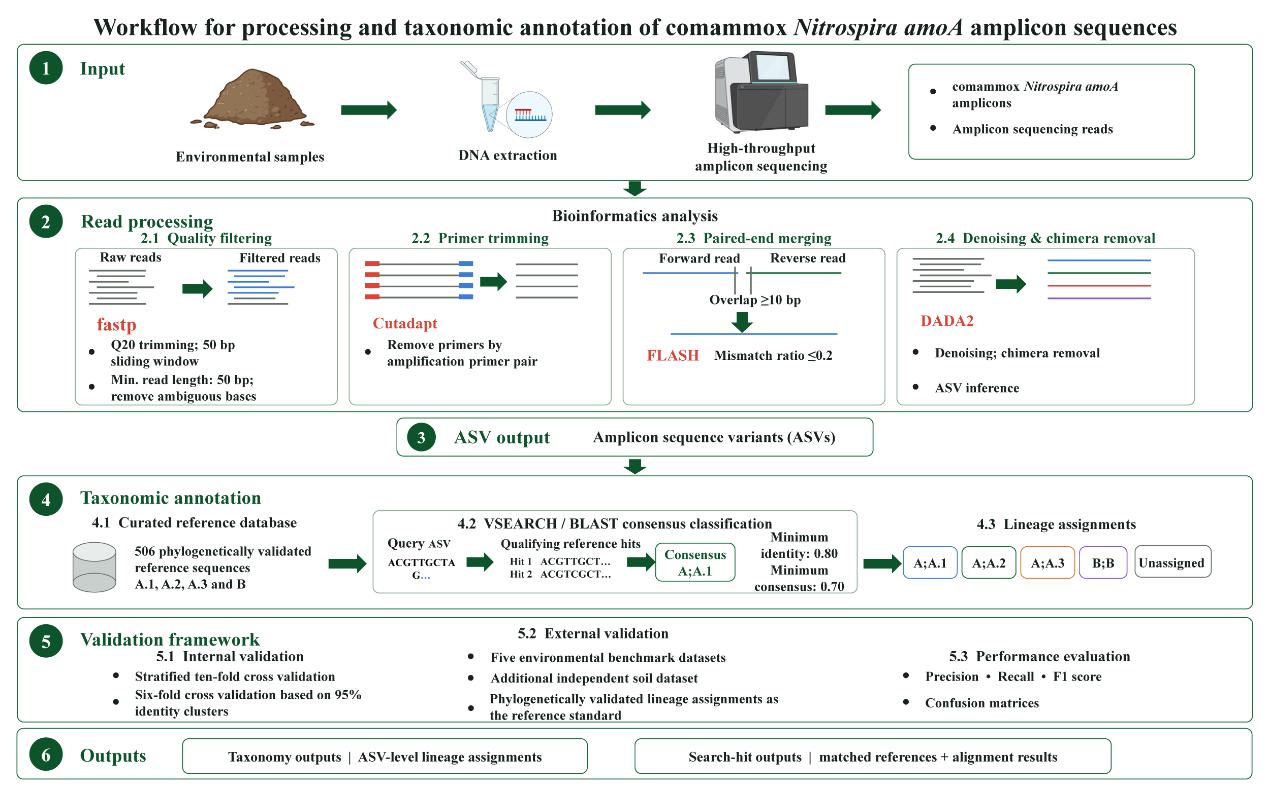
图1 Comammox Nitrospira 扩增子序列分析注释流程
原文链接:https://www.sciencedirect.com/science/article/pii/S1164556326000762